구글 서치콘솔을 열었더니 사이트 주소 1,000개 넘게 '발견됨 - 현재 색인이 생성되지 않음' 이었습니다. URL 검사에선 'Robots.txt를 찾을 수 없음', 사이트맵은 '사이트맵을 읽을 수 없음' 까지 떴습니다. 처음엔 우리가 걸어 둔 봇 차단이 구글까지 막고 있다고 생각했습니다.
결론부터 말하면 차단은 없었습니다. 원인은 옮긴 지 18일 된 새 도메인이라 구글이 아직 가져가기를 미루고 있었던 것이고, 빨간 오류들은 대부분 한 번 실패한 기록이 남아 있던 것이었습니다. 이 글은 오시레이더(치지직 버튜버 대시보드)를 대상으로 차단 가능성을 하나씩 지운 순서와, 그 뒤에 남은 할 일을 정리한 것입니다.
'발견됨 - 현재 색인이 생성되지 않음'은 무슨 뜻인가
구글이 주소는 알지만 아직 가져가지도 않은 상태입니다. 페이지 품질을 따지기 전 단계라, 대개 사이트 신뢰가 아직 낮아 크롤링 순서가 뒤로 밀린 것입니다. 저희 사이트의 '페이지 색인 생성' 보고서는 이랬습니다.
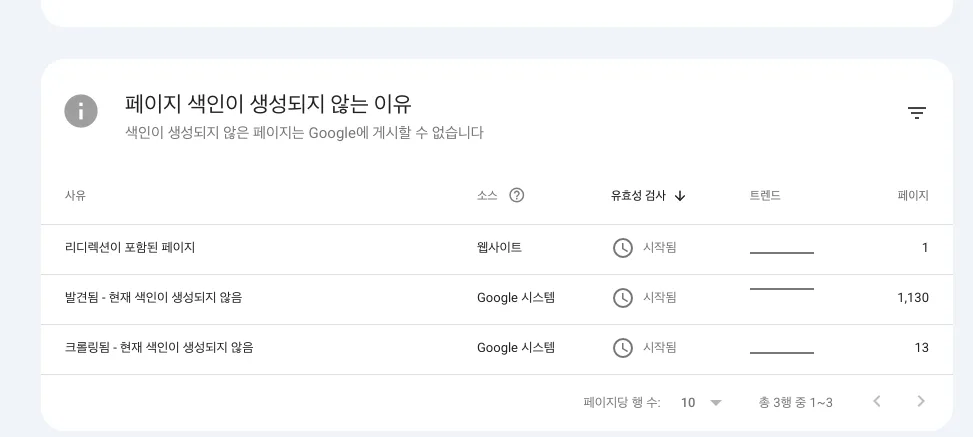
| 사유 | 페이지 | 뜻 |
|---|---|---|
| 발견됨 - 현재 색인이 생성되지 않음 | 1,130 | 주소는 아는데 아직 가져가지도 않았다 |
| 크롤링됨 - 현재 색인이 생성되지 않음 | 13 | 가져가 읽었는데 넣지 않았다 |
| 리디렉션이 포함된 페이지 | 1 | 옛 주소 → 새 주소 301. 정상 |
'크롤링됨' 13개를 열어 보니 오시레이더 홈과 3D 은하 페이지까지 있었습니다. 서비스 첫 화면조차 색인이 안 된 상태였습니다.
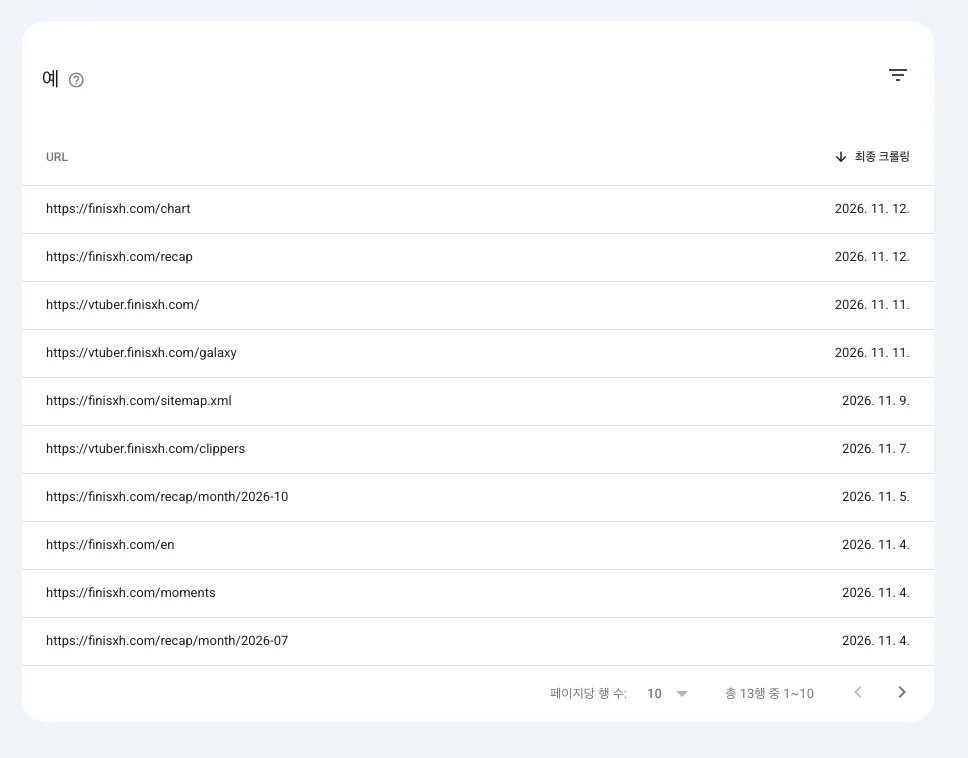
여기서 하나 알아 둘 점이 있습니다. 이 속성은 finisxh.com 도메인 속성이라 루트 도메인의 다른 서비스(Finisxh)와 서브도메인(오시레이더)의 숫자가 섞여 있습니다. 1,130개도 두 서비스를 합친 수입니다.
홈을 URL 검사로 실시간 테스트하자 더 무서운 문구가 떴습니다.
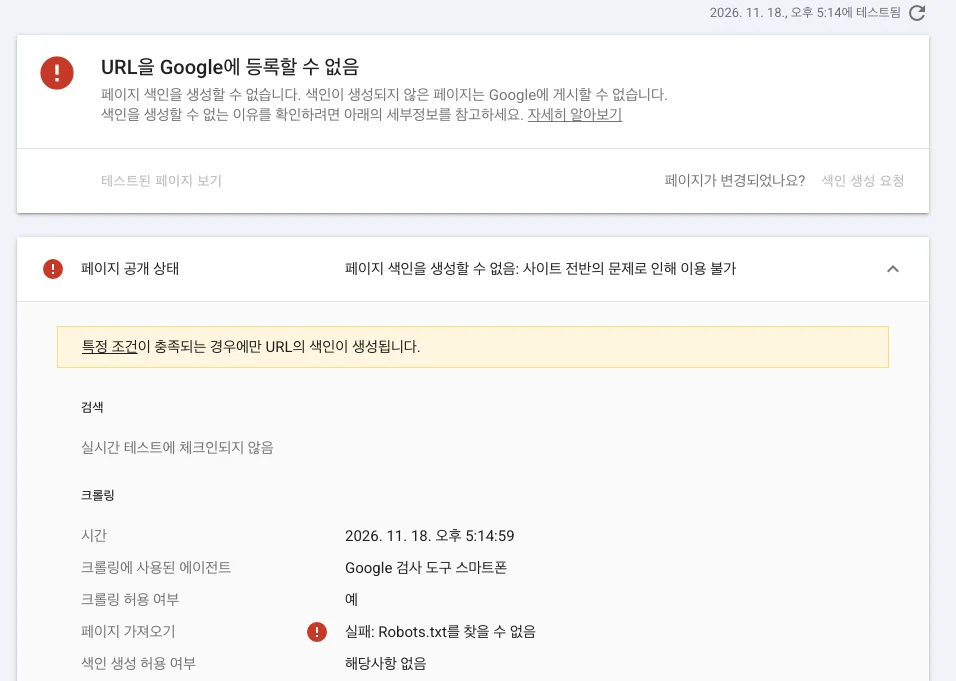
'사이트 전반의 문제로 인해 이용 불가' · '실패: Robots.txt를 찾을 수 없음'. 구글이 robots.txt 를 못 받으면 사이트 전체 크롤링을 멈추기 때문에, 이게 사실이면 원인이 확실해 보였습니다.
서브도메인과 루트 도메인이 서로 막지는 않는다
처음 든 생각은 "루트 도메인 서비스와 서브도메인 서비스가 둘 다 커서 구글이 한쪽만 넣어 주는 것 아닌가"였습니다. 그렇지 않습니다. 구글은 finisxh.com 과 vtuber.finisxh.com 을 사실상 별개 사이트로 보고, 색인도 주소마다 따로 판단합니다. 도메인 속성은 서치콘솔에서 묶어 보여 주는 단위일 뿐입니다.
robots.txt · noindex · canonical 부터 — 구글봇 이름으로 직접 열어 본다
사이트가 스스로 막고 있는지는 구글봇 이름(User-Agent)으로 직접 열어 보면 바로 보입니다. robots.txt 응답 코드, 페이지의 noindex · canonical 을 차례로 봅니다.
GB="Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
curl -sI -A "$GB" https://example.com/robots.txt      # 200 이어야 한다
curl -s  -A "$GB" https://example.com/ | grep -oE '<(link rel="canonical"|meta name="robots")[^>]*>'
curl -sI -A "$GB" https://example.com/ | grep -i x-robots-tag
| 확인 | 정상이면 | 저희 결과 |
|---|---|---|
| robots.txt | 200, 구글(* 또는 Googlebot)에 Disallow: / 없음 | 정상 |
meta robots · X-Robots-Tag | noindex 없음 | 정상 |
| canonical | 각 페이지가 자기 주소 | 정상 |
| 구글봇 이름으로 주요 페이지 | 200, 본문이 HTML 에 들어 있음 | 정상 |
| 옛 주소 | 같은 경로로 301 | 정상 |
여기까지는 깨끗했습니다. 다만 이건 제 컴퓨터에서 보낸 요청이라, 구글이 자기 IP 에서 보냈을 때도 같은지는 아직 모릅니다. 사이트 앞에 방화벽이나 봇 차단이 있으면 구글이 받는 응답은 제가 받는 것과 다를 수 있습니다.
서버 요청 로그로 진짜 구글봇이 받은 응답 보기
호스팅의 요청 로그에서 진짜 구글봇 요청을 찾아, 응답 코드와 방화벽 동작을 보면 됩니다. 저희 호스팅은 요청마다 응답 코드와 방화벽이 통과시켰는지 막았는지를 남겨 줘서, 로그를 받아 구글봇 것만 걸렀습니다(CLI 로 로그 · 사용량 보기).
시각(UTC)          경로          응답  방화벽  국가  User-Agent
2026-11-17T21:34  /robots.txt   200   통과    US   Googlebot/2.1
2026-11-18T08:21  /robots.txt   200   통과    US   Googlebot/2.1
2026-11-18T08:24  /robots.txt   200   통과    US   Googlebot/2.1
진짜 구글봇은 robots.txt 를 200 으로, 방화벽을 통과해 받아 가고 있었습니다. 같은 기간 방화벽이 막은 요청 중에 구글은 하나도 없었습니다.
그럼 'Robots.txt를 찾을 수 없음'은 뭐였을까요. 실시간 테스트를 누른 시각 앞뒤로 로그를 보니 구글 검사 도구의 요청이 아예 들어오지 않았습니다. 서버가 거절한 게 아니라 요청이 오지 않았던 겁니다. 실시간 테스트의 이 문구는 구글 쪽 일시 오류로도 뜹니다. 몇 분 뒤 다시 누르면 지나가는 경우가 많습니다.
구글봇인 척하는 요청도 많으니, 로그에서 볼 땐 국가 · IP 를 같이 봅니다. 확실히 하려면 구글이 공개한 구글봇 확인 방법(역방향 DNS)을 씁니다.
CDN 봇 차단은 요청이 그 CDN 을 지날 때만 적용된다
DNS 를 CDN 회사에 맡겼더라도, 레코드가 프록시를 거치지 않으면 그 CDN 의 봇 차단 · 방화벽은 요청에 닿지 않습니다. dig 로 주소가 CDN 의 IP 로 가는지, 호스팅으로 바로 가는지 보면 가려집니다.
dig +short example.com              # 결과가 CDN IP 인가, 호스팅 주소인가
dig +short @8.8.8.8 example.com     # 구글 DNS 로도 같은 답인가
예를 들어 Cloudflare 는 레코드가 '주황 구름(프록시)'일 때만 봇 차단(Bot Fight Mode) · 방화벽 · AI 크롤러 차단이 동작하고, '회색 구름(DNS only)'이면 대시보드에서 켜 둬도 적용되지 않습니다. 저희 경우엔 CDN 쪽 봇 차단이 요청 경로에 없어서 원인에서 빠졌습니다. 반대로 나중에 프록시를 켜면 그때부터 봇 차단이 구글을 막을 수 있으니, 같이 확인해야 합니다.
구글 DNS(8.8.8.8)로 조회해도 정상인지도 봅니다. DNSSEC 서명이 어긋나면 내 컴퓨터에선 열리는데 구글만 주소를 못 찾는 일이 생깁니다.
'사이트맵을 읽을 수 없음'은 한 번 실패한 기록이 남아 있던 것
사이트맵 화면엔 빨간 오류가 있었습니다.
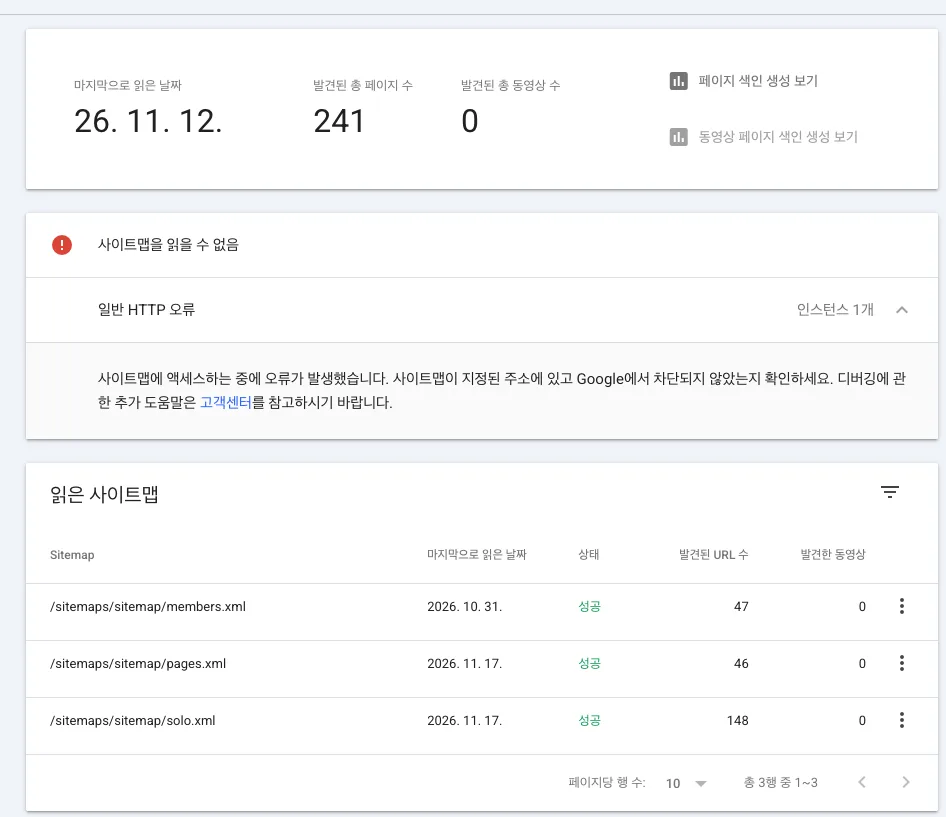
그런데 자세히 보면 이상합니다. /sitemap.xml 은 목차(sitemap index) 로 하위 사이트맵 3개를 가리키는데, 하위 3개는 모두 '성공' 이고 주소 241개도 이미 받아 갔습니다. 실패한 건 목차 파일 하나, 그것도 11월 12일에 한 번이었습니다. 구글은 실패한 사이트맵을 바로 다시 읽지 않아서, 그 기록이 6일 동안 그대로 보이고 있었습니다.
주소가 수백 개뿐이라 목차로 나눌 이유가 없어서, /sitemap.xml 을 주소 전부를 담은 한 파일(urlset) 로 바꾸고 다시 제출했습니다. 이번엔 바로 '성공'이 떴습니다.
솔직히 적어 두면, 바꾸기 직전에도 구글은 옛 목차 파일을 200 으로 받아 갔습니다(로그에 남아 있습니다). 성공으로 바뀐 직접 이유는 형식보다 다시 제출해서 구글이 다시 읽은 것입니다. 한 파일로 바꾼 건 앞으로 목차만 실패하는 경우를 없앤 정도의 효과입니다. 11월 12일에 왜 실패했는지는 로그가 하루치만 남아 있어 알 수 없었습니다.
진짜 원인 — 도메인 이전 뒤 새 도메인이라 구글이 가져가기를 미루고 있었다
차단을 다 지우고 나면 남는 건 신뢰입니다. '발견됨 - 현재 색인이 생성되지 않음'은 구글이 주소를 사이트맵 · 링크로 이미 알지만, 사이트를 아직 믿지 못해 크롤링 순서를 뒤로 미룬 상태입니다.
- 오시레이더는 10월 31일에 새 도메인으로 옮겼습니다. 조사한 날 기준 18일째였습니다.
- 밖에서 이 사이트로 들어오는 링크가 거의 없었습니다.
- 같은 도메인 속성의 루트 서비스(Finisxh)는 색인이 되고 있었는데, 그쪽엔 대만 야후 뉴스에 인용된 링크가 있었습니다. 설정은 같고, 다른 건 바깥 링크였습니다.
새 사이트가 처음부터 주소 천 개를 내밀면, 구글은 홈 같은 몇 장만 먼저 보고 나머지는 조심스럽게 조금씩 가져갑니다. 고장이 아니라 판단 대기 중인 셈입니다.
그래서 할 일 — 기다리는 동안 속도를 올리는 법
| 할 일 | 어디서 | 효과 |
|---|---|---|
| URL 검사 → 색인 생성 요청, 하루 10개 정도 | 서치콘솔 | 가장 빠릅니다. 홈 → 주요 목록 · 순위 → 인기 상세 순서로 |
| 밖에서 들어오는 링크 | 내 다른 사이트 · 블로그 · 커뮤니티 | 신뢰를 올리는 가장 확실한 방법 |
| 옛 도메인 속성에서 주소 변경 제출 | 서치콘솔(옛 속성) | 옛 주소가 쌓은 신뢰를 넘겨받음 |
| 설정 → robots.txt 보고서 에서 다시 크롤링 요청 | 서치콘솔 | 예전 실패 기록 지우기 |
| 사이트맵 다시 제출 | 서치콘솔 | 한 번 실패한 기록이 남아 있으면 |
네이버 · 빙은 바뀐 주소를 직접 알려 줄 수 있어서 따로 챙겼습니다(IndexNow 로 Bing · 네이버에 바로 알리기). 구글은 IndexNow 를 받지 않아서 위 방법이 전부입니다.
정리 — 색인이 안 될 때 확인 순서
- robots.txt · noindex · canonical — 구글봇 이름으로 직접 열어 본다
- 서버 요청 로그 — 진짜 구글봇이 받은 응답 코드와 방화벽 동작을 본다. 실시간 테스트 시각에 요청이 안 왔으면 구글 쪽 일시 오류
- CDN 을 지나는지 —
dig결과가 CDN IP 가 아니면 그 CDN 의 봇 차단은 적용되지 않는다. 구글 DNS 로도 조회 - 사이트맵 오류의 날짜 — 하위는 성공인데 목차만 실패한 오래된 기록이면 다시 제출
- 다 정상이면 새 도메인 · 바깥 링크 부족 — 색인 요청과 링크로 시간을 줄인다
차단부터 의심했지만, 확인해 보니 막힌 곳은 없었습니다. 남은 건 시간과 링크였고, 1~2주 뒤 '색인됨'이 얼마나 늘었는지 다시 보려고 합니다.